Gemini
סבתא מרוקאית מ-Gemini: מה למדתי מהמודל החדש של גוגל לקול בעברית
ערב אחד עם Gemini 3.8 Flash TTS: עיצבתי סבתא מרוקאית בת 85 ונכדה שמזייפת "יום הולדת שמח". מה עבד, מה נחסם, מה עלה (אפס שקלים), ותיאורי קול להעתקה.
גוגל הוציאה מודל קול חדש, Gemini 3.8 Flash TTS, שמעצב קולות מתיאור במילים. רציתי לבדוק אותו על הסצנה הכי ישראלית שיכולתי לחשוב עליה: ילדה שרה לסבתא "יום הולדת שמח", מזייפת, הקול נשבר, וסבתא מרוקאית קוטעת אותה: "כפרה עליק בינתי, איזה קול של זמיר יש לך, אני רושמת אותך לכוכב הבא, רק תפסיקי לשיר".
ניסיון ראשון: נשמע כמו הקראה
בניסיון הראשון כתבתי לכל דמות פסקת תיאור ארוכה, ולסבתא נתתי את כל הטקסט שלה בבת אחת. העברית יצאה מדויקת מילה במילה (בדקתי בתמלול), אבל התוצאה הייתה מאכזבת:
הסבתא נשמעת צעירה מדי, והכול באותו טון.
שתי בעיות: הסבתא לא נשמעה בת 80, והמבטא לא היה כבד מספיק. וגם הכול יצא מונוטוני: כשמודל מקבל פסקה שלמה, הוא בוחר טון אחד ונשאר בו.
מה שינה את התוצאה
1. תיאור קול קצר, דמות אחת
המדריך הרשמי של גוגל ממליץ על תיאור של משפט או שניים: גיל, מגדר, גוון, טקסטורה ומבטא. זרקתי את הפסקה, כתבתי שלוש סבתות חלופיות, בנות 85, ושמעתי כל אחת. זו שבחרתי המציאה לעצמה פתיחה: "קזבלנקה, יא חביבי".
את הטקסט הזה המודל כתב לבד, מתוך התיאור.
An elderly 85-year-old woman who came from Casablanca in the 1950s, speaking Hebrew with a thick Moroccan Arabic accent and melody. Deep, cracked, gravelly old-lady voice with a tremor and wheezy breath, loud, expressive and theatrical.והטריק החשוב: גיל ומבטא נכנסים לתיאור הקול, לא להוראות המשחק. הם תכונות קבועות של הדמות. כל מה שמשתנה בין משפט למשפט (שמחה, קטיעה, עייפות) נכנס בנפרד, בשדה שנקרא style.
2. לפרק את הטקסט לחתיכות
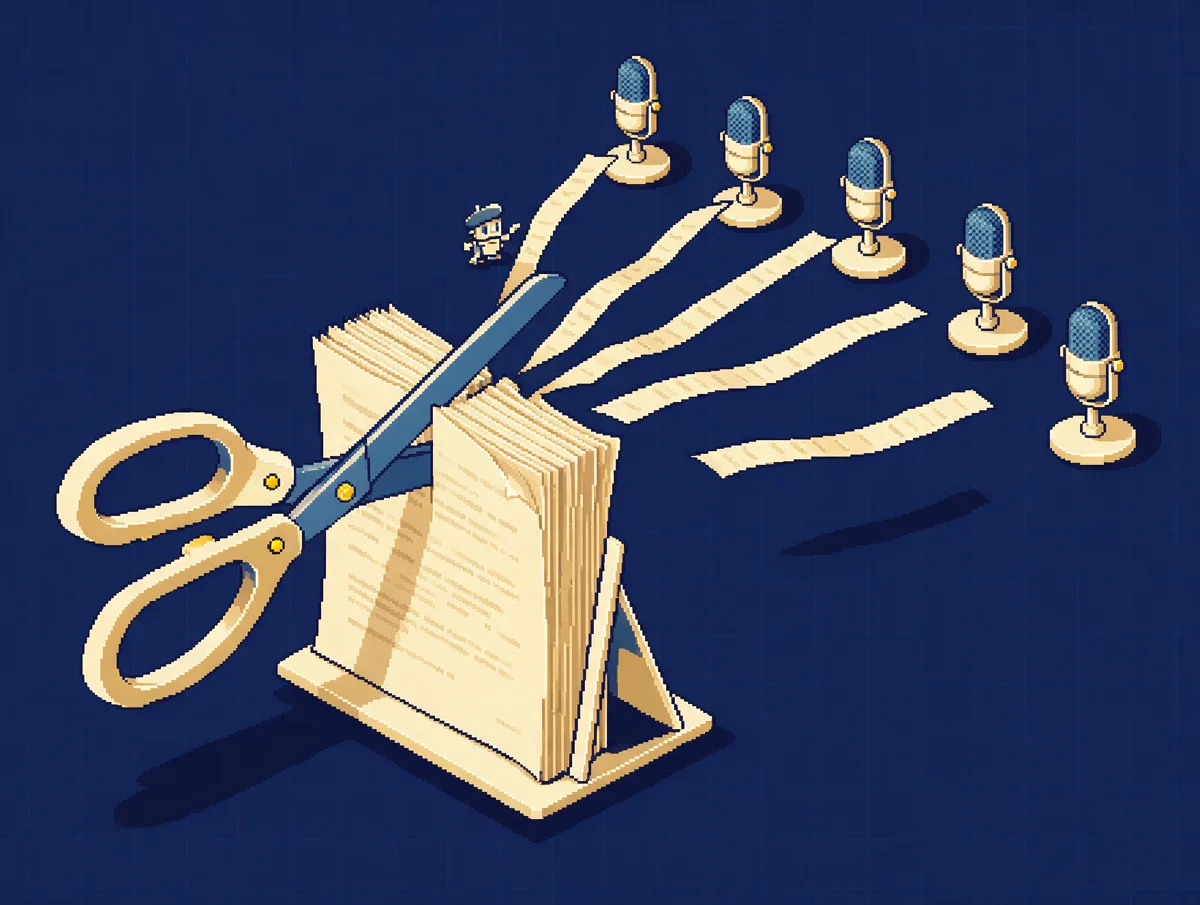
במקום פסקה אחת, כל משפט הוא קריאה נפרדת עם הוראת משחק משלו. הילדה קיבלה שלוש: שרה בגאווה, שרה חזק יותר ומזייפת, מנסה להגיע לתו גבוה והקול נשבר. הסבתא קיבלה חמש. אחר כך מדביקים, וסבתא נכנסת רגע לפני שהילדה מסיימת, כמו שקוטעים באמת.
הילדה נשברת בסוף, הסבתא עולה ויורדת. (זו עוד לא הסבתא שבחרתי, אלא מועמדת 1.)
text:  "איזה קול... של זמיר יש לך! <chuckle>"
style: "over-the-top fake praise, drawn out"
התגיות בתוך הטקסט הן רגעים קצרים שהמודל משחק ולא מקריא: <laugh>, <chuckle>, <sigh>, <gasp>, <short pause>. שלוש נקודות הן עצירה.
מה נשבר, ומה כל שבירה לימדה
גוגל חוסמת קולות של ילדים
ניסיתי שבעה ניסוחים לקול של הילדה: עם גיל, בלי גיל, "דמות מצוירת", "קול של תוכנית ילדים". כולם נחסמו, עם אותה הודעה:
Voice prompt was blocked by safety policies.גם בספריית הקולות של גוגל אין אף קול של ילד. מה שעבד: לתאר מבוגרת שעושה קול של ילדה. שחקנית דיבוב בת 20 עם קול קרטון גבוה. זה הגיוני: דיבוב ילדים בטלוויזיה נעשה כמעט תמיד על ידי מבוגרים.
A 20-year-old Israeli voice actress speaking native Hebrew who performs a very high, squeaky, cartoon-character voice - bright, bouncy and enthusiastic, cracking on high notes.המודל המציא לה מונולוג של הכנות למסיבת הפתעה.
האתר של גוגל נכשל, ה-API עבד
ב-Google AI Studio יש כפתור Create new voice, ואז Voice Design. אצלי הוא נכשל שוב ושוב עם The caller does not have permission, גם אחרי החלפת מפתח. אותו מודל, דרך ה-API, עבד בניסיון הראשון. אם זה קורה לכם, לא צריך לדבג: תנו לקלוד לעשות את זה.
יש לי מפתח Gemini API בקובץ [נתיב]. תעצב לי קול חדש ב-Gemini 3.8 Flash TTS דרך POST /v1beta/voices (type: prompted, language_code: he-IL) לפי התיאור הזה: [תיאור באנגלית, משפט-שניים]. אחר כך תרנדר את התסריט המצורף משפט אחרי משפט דרך /v1beta/interactions, כל משפט עם style משלו, תדביק לקובץ אחד ותנרמל ל-16- LUFS. תאמת בתמלול Whisper שהעברית יצאה נכון.מסלול חינם: 10 בקשות ליום
המפתח שהשתמשתי בו התברר כמסלול החינמי: 3 בקשות לדקה ו-10 ליום. זה מספיק לשני קולות ולסבב אחד של דיאלוג, לא יותר. בסבב השני נעצרתי באמצע.
| חינם | בתשלום | |
|---|---|---|
| מחיר | 0 | 9$ למיליון טוקני שמע (עד סוף 2026) |
| דיאלוג של 30 שניות | 0 | כ-750 טוקנים, 2-3 אגורות |
| מגבלה | 10 בקשות ליום | לפי המכסה של הפרויקט |
מה עוד לא פתרתי
"כפרה עליק". המודל מתעקש להגיד "עלייך", בעברית תקנית. ניסיתי ניקוד, והוא לא עזר. בסבב הבא אני בודק שלוש כתיבות: באותיות לטיניות (Kapara alik, ya binti), בעברית עם כ' סופית דגושה, ובאותיות ערביות בתוך המשפט. המדריך יתעדכן עם מה שעבד.
והמבטא: הוא טוב, לא מושלם. מבטא כבד הוא הדבר הכי קשה לקול סינתטי, כי המודל נמשך כל הזמן לעברית "נקייה".
איפה הייתי מתחיל היום
- כותבים את הדמות במשפט-שניים באנגלית: גיל, מגדר, גוון, מבטא. בלי פסקאות.
- מבקשים שלוש גרסאות לאותו תיאור ובוחרים באוזן. זה זול, וההבדלים גדולים.
- מפרקים את התסריט למשפטים, ולכל משפט נותנים הוראת משחק אחת קצרה.
- מוסיפים 1-2 תגיות כמו <laugh> או <sigh>, לא יותר.
- צריכים ילד? מתארים שחקן או שחקנית דיבוב מבוגרים שעושים קול של ילד.
- בודקים בתמלול שהעברית יצאה נכון, ואז מקשיבים שוב, כי תמלול לא שומע מבטא.
מודל קול לא צריך פסקה על הדמות. הוא צריך במאי שעומד ליד כל משפט.
FAQ
האם Gemini TTS מדבר עברית?
כן. Gemini 3.8 Flash TTS תומך ב-130 שפות, כולל עברית (language_code: he-IL). בספריית הקולות של גוגל אין קולות עבריים מוכנים, ולכן בעברית מעצבים קול חדש מתיאור במילים (Voice Design).
אפשר ליצור ב-Gemini קול של ילד?
לא ישירות. כל תיאור של קול ילד נחסם עם ההודעה Voice prompt was blocked by safety policies, וגם בספרייה אין קולות ילדים. מה שעובד הוא לתאר מבוגר או מבוגרת, למשל שחקנית דיבוב בת 20, שעושים קול גבוה של דמות מצוירת.
כמה עולה Gemini 3.8 Flash TTS?
יש מסלול חינמי עם 10 בקשות ליום ו-3 לדקה. בתשלום: 9 דולר למיליון טוקני שמע ו-0.50 דולר למיליון טוקני טקסט עד סוף 2026, כשכל שנייה של שמע היא 25 טוקנים. דיאלוג של 30 שניות עולה פחות מסנט.
איך גורמים לקול AI להישמע פחות מונוטוני?
מפרקים את הטקסט למשפטים ומרנדרים כל משפט בנפרד, עם הוראת משחק קצרה משלו (למשל: laughing, deadpan, proud) ותגית אחת או שתיים כמו <laugh> או <sigh>. כשהמודל מקבל פסקה שלמה, הוא בוחר טון אחד ונשאר בו.